pandas, Polars, Spark y T-SQL para agentes de IA
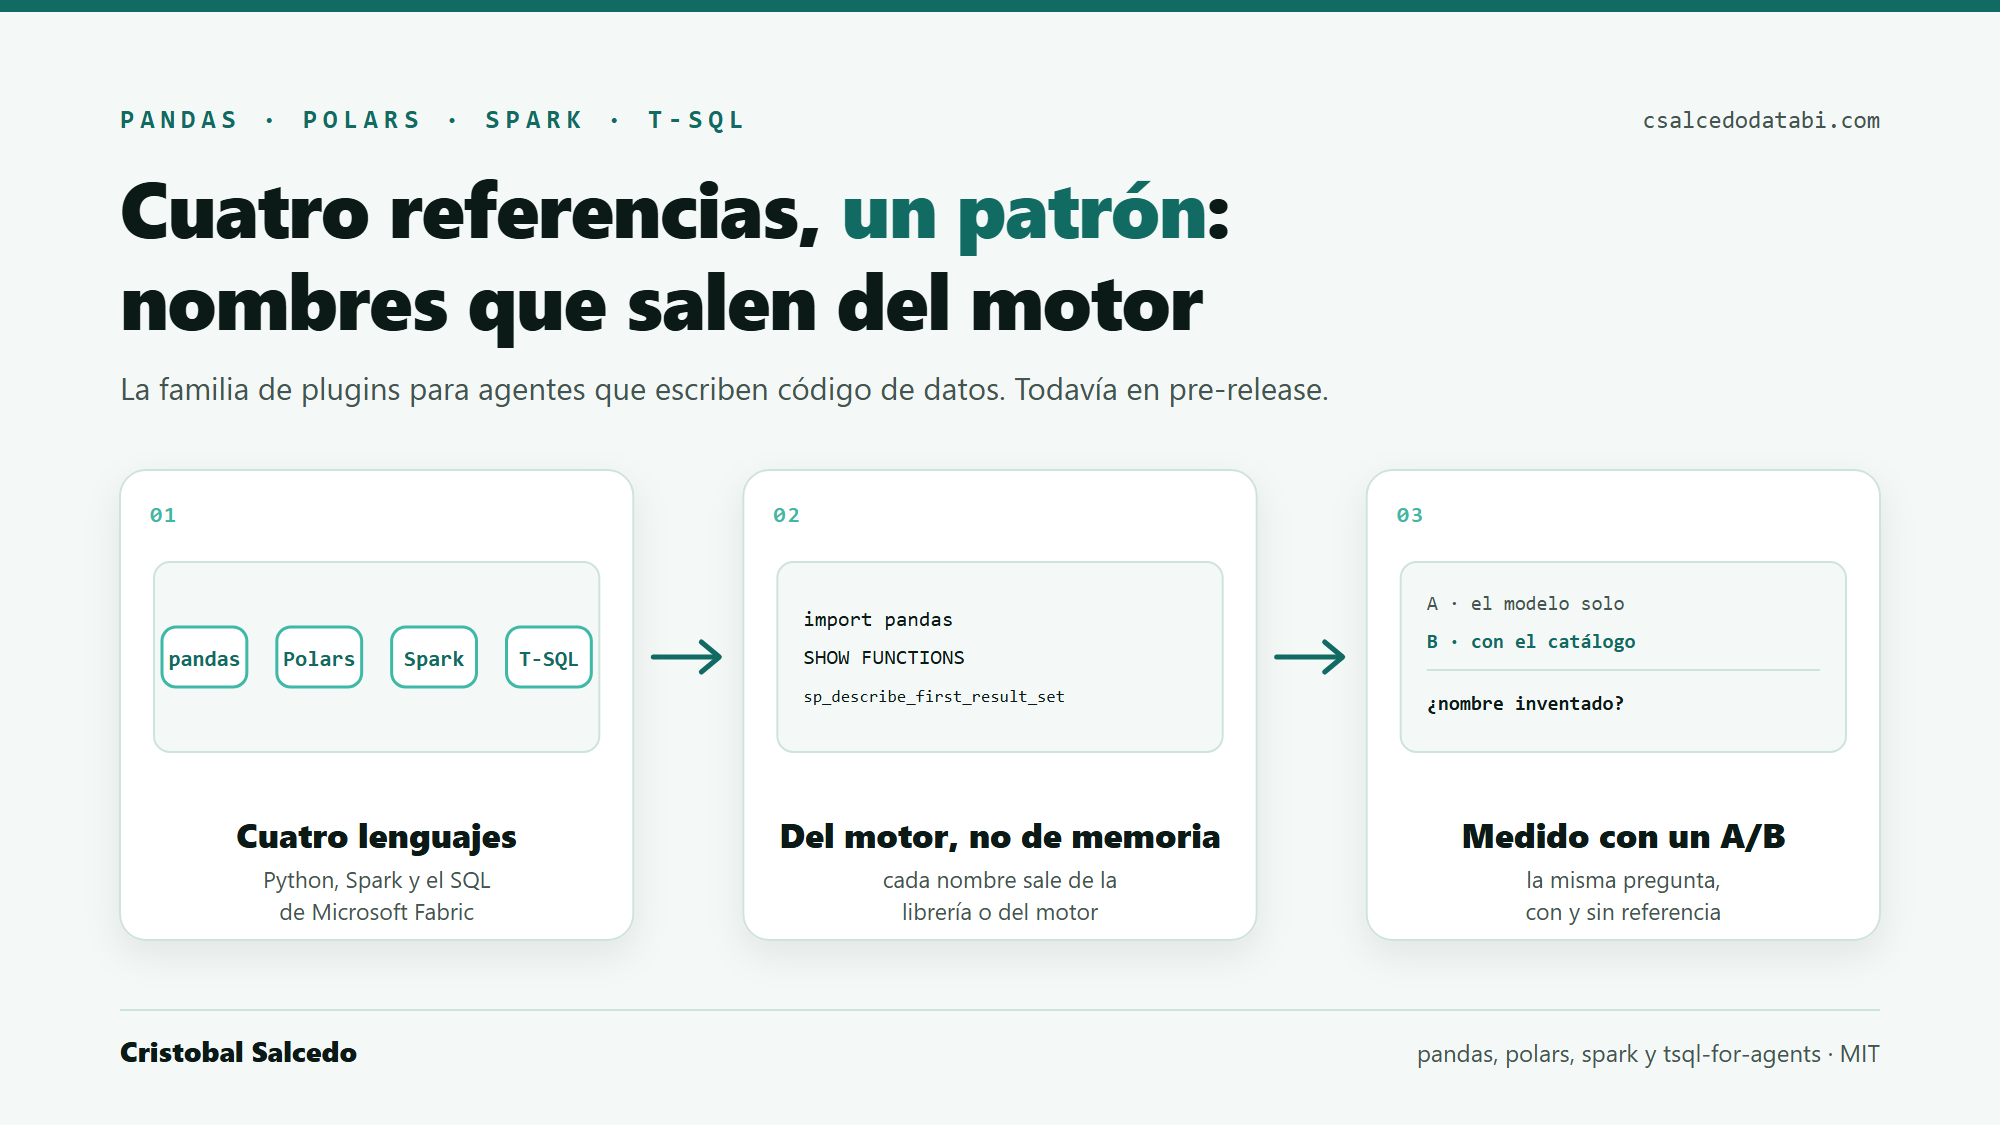
En resumen — Son cuatro repositorios con la misma regla que dax-for-agents y powerquery-m-for-agents: un agente nunca lee un nombre que no salió del motor. pandas, Polars, Spark y T-SQL de Fabric. Los cuatro son públicos desde el primer día, MIT y todavía en pre-release: hoy no hay plugin que instalar.
Antes de seguir: todavía no se instalan
Los cuatro README lo dicen arriba del todo: nada está listo para instalar y no hay plugin que agregar. Lo que sí existe es lo que cuenta este artículo — los catálogos, los checks y las mediciones. Cada README dice qué falta para la primera versión.
El patrón: exportar, comprobar, medir
Los cuatro repiten tres pasos.
- Exportar los nombres de la fuente. No se escriben de memoria: se sacan de la librería instalada o del motor.
- Comprobar cada nombre en CI. Una ficha que usa un nombre que no está en el catálogo no pasa.
- Medir si sirve. Cada pregunta de un banco se le hace dos veces al mismo modelo: sola (brazo A) y con las filas del catálogo de su categoría (brazo B: nombres y resumen de una línea, nunca la ficha con la respuesta). Cada nombre que la respuesta escribe en código ejecutable se busca en el catálogo con el propio checker del repositorio. Ningún modelo juzga a otro, y cualquier corrida guardada se recuenta gratis con
--replay.
python evals/hallucination/run_ab.py --model claude-haiku-5-5 --out run.json
python evals/hallucination/run_ab.py --replay evals/hallucination/runs/<corrida>.json
Lo que cambia es de dónde sale la verdad en cada lenguaje.
pandas: los nombres que ya no existen
pandas-for-agents exporta de la librería instalada cada función de primer nivel y cada método de DataFrame, Series, Index, GroupBy, Resampler y los accesores .str, .dt, .cat, .sparse y .plot. Cada uno con su firma, su resumen y si está deprecado o se quitó entre pandas 2.x y la versión actual.
Esa última parte es la trampa en la que más cae un agente, y el A/B la muestra:
| Modelo | Preguntas | Inventadas sin la referencia | Inventadas con ella |
|---|---|---|---|
| Claude Haiku 5.5 | 13 | 0 | 0 |
| Claude Haiku 4.5 | 13 | 1 | 0 |
El único invento que quitó la referencia es el que lo explica todo: para aplicar una función a cada celda, Haiku 4.5 escribió DataFrame.applymap, que se quitó en pandas 3.x. Con las filas actuales del catálogo delante, el mismo modelo usó DataFrame.map. Un modelo entrenado con pandas 2.x recuerda nombres que ya no están.
Polars: medir aunque hoy no falle
polars-for-agents exporta de polars cada expresión y sus espacios de nombres (.str, .dt, .list, .arr, .struct, .cat, .name), DataFrame, LazyFrame, Series, las funciones de primer nivel y los selectores, fijados por versión y con la marca de deprecado o inestable.
| Modelo | Preguntas | Inventadas sin la referencia | Inventadas con ella |
|---|---|---|---|
| Claude Haiku 5.5 | 23 | 0 | 0 |
| Claude Haiku 4.5 | 23 | 1 | 2 |
Aquí la tabla no favorece a la referencia, y el README lo dice tal cual: un modelo actual no inventa nombres de Polars en este banco, con o sin ayuda. Donde Haiku 4.5 tropezó fue en el espacio Expr.arr, y las filas del catálogo no lo salvaron — una lista de nombres ayuda menos que una ficha abierta. El valor está en la medición que sigue funcionando: detectará una regresión y enseñará el hueco el día que detrás del agente haya un modelo más barato.
Spark: el catálogo del propio motor
spark-for-agents cubre PySpark y Spark SQL con cada función integrada exportada del motor: SHOW FUNCTIONS y DESCRIBE FUNCTION EXTENDED corridos en un Spark real, más la introspección del paquete pyspark. El plan es que cada ficha diga en qué versión de Spark apareció la función y si el runtime de Microsoft Fabric la tiene.
El A/B se hace sobre lo que un agente de Spark inventa: el nombre de la función, tanto en F.<nombre> como dentro de un spark.sql(...), contra 422 funciones de PySpark y más de 430 de Spark SQL. En este banco, ni Haiku 5.5 ni Haiku 4.5 inventaron una sola en 15 preguntas, con o sin referencia. Spark está muy presente en el entrenamiento; la medición queda puesta para el día que deje de estarlo.
T-SQL en Fabric: cuando el motor no se describe solo
tsql-for-agents es el caso difícil. T-SQL no se describe a sí mismo: LEN o DATEADD no son filas de sys.objects, así que no hay un SHOW FUNCTIONS que exportar. El método honesto tiene tres pasos:
- Una lista de candidatas tomada de la referencia oficial de funciones de T-SQL.
- Cada candidata se sondea en un motor de Fabric con un
SELECTmínimo a través desp_describe_first_result_set, que compila la sentencia y nunca la ejecuta. El resultado registra si el nombre existe, el error del motor si no (no es lo mismo «no soportada» que «no reconocida») y el tipo que devuelve. - Las vistas y procedimientos del sistema salen directamente de
sys.all_objectsysys.all_parameters.
El alcance es Microsoft Fabric: el Warehouse y el SQL analytics endpoint de un Lakehouse. La primera corrida fue contra un SQL analytics endpoint; la del Warehouse está pendiente. Este repositorio todavía no tiene A/B publicado.
Lo que no son
- No ejecutan código. Son referencias que un agente lee.
- No son tutoriales. Cuando ya existe una buena guía escrita a mano, se enlaza: la skill de pandas de PatrickGallucci/fabric-skills, la de Polars de K-Dense-AI/claude-scientific-skills.
- No administran Fabric. Correr jobs de Spark, cargar un Warehouse o diagnosticar consultas es trabajo de las skills de Fabric.
Ninguno está todavía en el directorio de plugins de Anthropic: se enviarán cuando salgan de pre-release.
→ pandas-for-agents · polars-for-agents · spark-for-agents · tsql-for-agents · Todos los plugins: Plugins para agentes
¿Te resultó útil este artículo?
Tu apoyo me permite seguir creando contenido de calidad.